本文面向需要了解 AI 行业技术演进的读者,按“标志性技术突破或行业拐点”划分阶段,不讨论低谷与寒冬,只看每一次范式跃迁是如何发生的。全文约 5800 字,建议收藏后分阶段阅读。
为什么要按“突破”来划分 AI 发展阶段
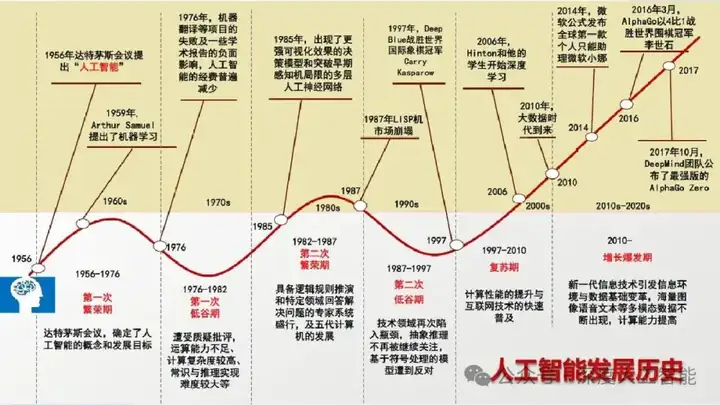
AI 的历史很容易被讲成一条起伏不定的曲线:热潮、低谷、再热潮。但如果把注意力放在“低谷/寒冬”上,反而会模糊技术演进的真正主线。更清晰的方式是:只按技术或行业突破来划分,每个阶段都由一个标志性突破或行业拐点开启。
这样划分有三个好处。
第一,标准统一。每个阶段的起点都是一个可验证的技术事件或行业事件,而不是主观感受的“热度高低”。达特茅斯会议、AlexNet 夺冠、ChatGPT 发布,这些都是有明确时间点、明确影响范围的事件。
第二,逻辑线清晰。每一次突破,本质上都在回答同一个问题:智能从哪里来? 符号主义说智能来自逻辑推理,连接主义说智能来自数据学习,预训练范式说智能来自海量数据的通用表示,Agent 说智能来自规划与执行。这条主线贯穿七十年,比“几起几落”的叙事更有解释力。
第三,对行业读者更有用。知道“现在处于哪个阶段”“这个阶段的突破点是什么”“下一个突破可能从哪里来”,比记住年份和模型名字更有决策价值。
下面从 1956 年开始,依次看七个阶段。每个阶段都按“突破—特征—代表—行业意义—局限或遗产”的结构展开,方便对照理解。
01、符号推理突破阶段(1956—1960s)
突破点:达特茅斯会议提出“人工智能”概念;Logic Theorist、GPS 等程序证明机器可以做逻辑推理。
1956 年夏天,达特茅斯学院的一场研讨会通常被视为 AI 作为独立学科的起点。John McCarthy、Marvin Minsky、Claude Shannon 等人聚在一起,讨论一个当时听起来很大胆的命题:“学习或者智能的任何其他特征,原则上都可以被精确描述,从而让机器来模拟它。” 这句话后来被反复引用,因为它第一次把“机器智能”从哲学思辨变成了工程目标。
真正让这个目标看起来可行的,是随后的几个程序。Allen Newell 和 Herbert Simon 开发的 Logic Theorist 能证明《数学原理》中的一些定理,其中一条证明甚至比罗素和怀特海的原证明更优雅。GPS(General Problem Solver,通用问题求解器)则尝试用“手段-目的分析”来求解问题:先看当前状态和目标状态的差距,再选择能缩小差距的操作。ELIZA 虽然简单,但用模式匹配模拟了对话,让很多人第一次感受到“机器好像能理解我”。
特征: 符号、规则、逻辑表达知识,走“推理即智能”路线。这一阶段的核心信念是:智能的本质是符号操作,只要把知识写成逻辑规则,机器就能通过推理表现出智能。
代表: 达特茅斯会议、Logic Theorist(逻辑理论家)、ELIZA(世界上首个聊天机器人程序)。
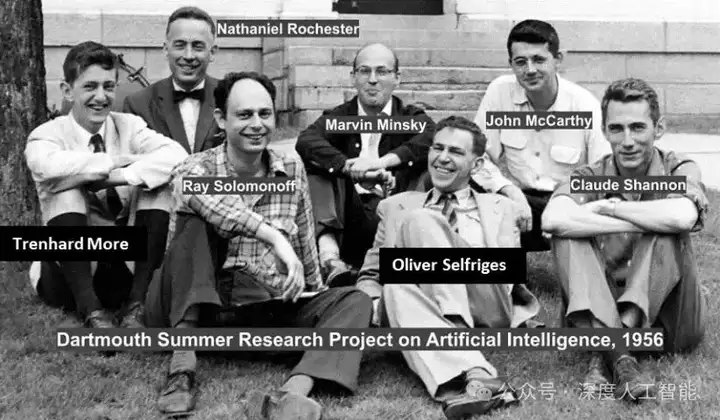
行业意义: 确立了 AI 作为独立学科的合法性,也确立了“符号主义”作为第一条技术路线。它让研究者相信,智能可以被形式化、被编程。
局限与遗产: 符号系统擅长逻辑,却难以处理真实世界中的模糊性、感知和常识。知识获取瓶颈很快显现:把专家知识写成规则,成本极高,且难以覆盖长尾情况。但符号推理留下的遗产——知识表示、推理引擎、逻辑编程——至今仍在专家系统、知识图谱、规则引擎中发挥作用。
02、感知机与连接主义突破阶段(1957—1969)
突破点:Rosenblatt 提出感知机,首次让机器从数据中“学习”分类边界。
1957 年,Frank Rosenblatt 在康奈尔航空实验室提出感知机(Perceptron)。它的结构今天看很朴素:输入层接收特征,权重与输入相乘后求和,再通过阈值函数输出分类结果。但它的意义在于,权重不是人工设定的,而是通过数据调整的。这就是“学习”的雏形。
感知机的训练规则很直观:如果分类正确,权重不动;如果分类错误,就朝着减小错误的方向调整权重。Rosenblatt 用硬件实现了感知机,能识别简单的图像,这在当时引起了巨大关注。《纽约时报》当时报道说,感知机未来可能能识别面孔、翻译语言。ADALINE(Adaptive Linear Neuron)等模型进一步推动了这一方向,它们使用最小均方误差来调整权重,成为后来线性回归和神经网络训练的基础。
特征: 神经网络雏形,连接主义路线登场。与符号主义不同,连接主义认为智能来自大量简单单元的连接和权重调整,而不是显式的逻辑规则。
代表: Perceptron(感知机)、ADALINE(自适应线性神经元)。
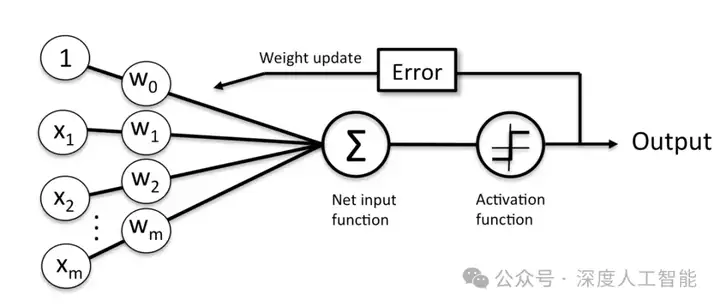
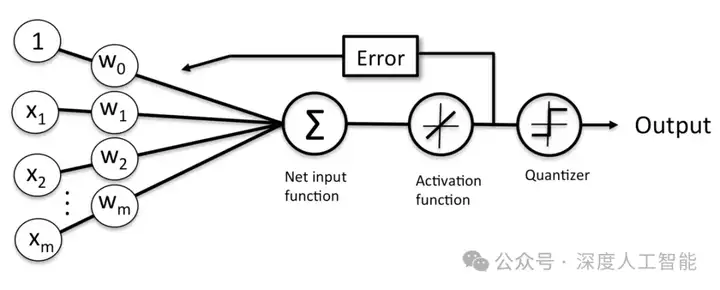
局限与遗产: 1969 年,Minsky 和 Papert 在《Perceptrons》一书中证明,单层感知机无法解决 XOR(异或)问题。这不是一个工程问题,而是一个数学上的根本局限:单层线性分类器无法表示非线性可分函数。这一结论导致连接主义热度下降,符号主义重新占据主导,AI 进入第一次低谷。
但感知机留下的核心思想——从数据中学习——后来成为机器学习的主线。更重要的是,它提出了一个至今仍然成立的观点:如果一个问题可以被表示为从输入到输出的映射,那么就可以尝试用数据来学习这个映射。
03、专家系统与知识工程突破阶段(1970s—1980s)
突破点:专家系统将领域知识做成规则库,在医疗、地质、诊断等场景落地。
当符号推理走向工程化,专家系统成为 AI 第一次大规模进入企业级应用的形态。它的基本结构是:知识库 + 推理引擎 + 人机接口。知识库由领域专家和知识工程师共同构建,把“如果……那么……”的规则写成计算机可处理的形式;推理引擎则根据输入事实和规则库,推导出结论。
几个标志性系统至今仍被提及。DENDRAL 用于化学结构分析,能根据质谱数据推断有机分子结构。MYCIN 用于血液感染诊断,能根据症状和化验结果推荐抗生素,其准确率在某些测试中接近人类专家。XCON 用于 DEC 公司的计算机配置,能根据客户需求自动生成硬件配置方案,据说每年为公司节省数千万美元。
特征: 知识工程、规则推理、行业应用。这一阶段的关键词是“知识获取”和“知识表示”:如何把专家脑子里的经验变成可维护的规则库,成为核心工程问题。
代表: DENDRAL(世界上首个专家系统)、MYCIN(早期医疗专家系统)、XCON(早期计算机专家系统)。
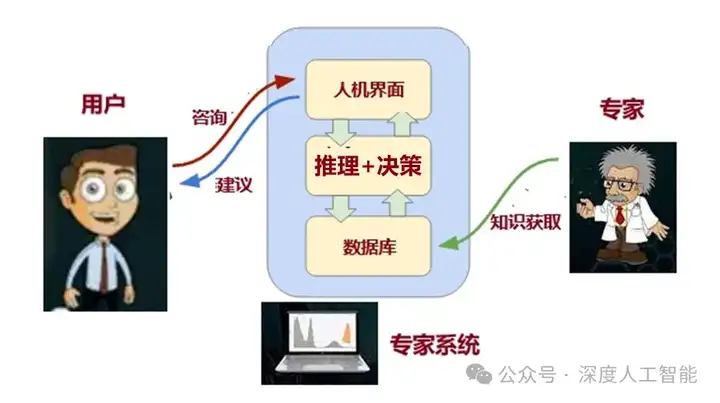
行业意义: AI 第一次大规模进入企业级应用。它证明了 AI 可以在特定领域产生实际商业价值,也催生了“知识工程师”这一职业。
局限与遗产: 专家系统的瓶颈很快暴露。知识获取困难:专家往往说不清自己是怎么判断的,把这些隐性知识写成规则非常耗时。规则维护成本高:规则数量一多,一致性和冲突检查就变得极其复杂。难以泛化:一个领域的规则库很难迁移到另一个领域。这些问题为下一阶段的“从数据中学习”埋下伏笔。但专家系统留下的遗产——知识库、推理引擎、领域建模——在今天的医疗诊断、金融风控、客服系统中仍然可见。
04、统计学习与机器学习突破阶段(1980s—2010s)
突破点:反向传播让多层神经网络可训练;SVM、决策树、随机森林、贝叶斯网络、HMM 等统计学习方法成熟。
这一阶段的核心转变是:从“手写规则”转向“从数据中学习”。1986 年,Rumelhart、Hinton 和 Williams 重新推广了反向传播算法,让多层神经网络的训练成为可能。反向传播的核心是链式法则:从输出层的误差出发,逐层向前计算梯度,再调整权重。这解决了多层网络的训练问题,也让神经网络重新回到研究视野。
但这一阶段真正的主角不只是神经网络。SVM(支持向量机)在 1990 年代由 Vapnik 等人发展成熟,它通过寻找最大间隔超平面来实现分类,在小样本高维数据上表现优异,且有坚实的统计学习理论基础。决策树和随机森林提供了可解释的集成方法,随机森林通过多棵树的投票来降低过拟合。贝叶斯网络用概率图模型表达变量之间的依赖关系,HMM(隐马尔可夫模型)则擅长处理序列数据,在语音识别中统治了多年。CRF(条件随机场)在序列标注任务中表现突出,成为 NLP 的重要工具。
特征: 从“手写规则”转向“从数据中学习”,概率统计成为主流。这一阶段的关键词是“特征工程”:模型能力有限,所以需要人工设计好的特征。特征工程做得好不好,往往决定模型效果的上限。
代表: BP 神经网络、SVM(支持向量机)、Random Forest(随机森林)、CRF(条件随机场)、HMM(隐马尔可夫模型)。
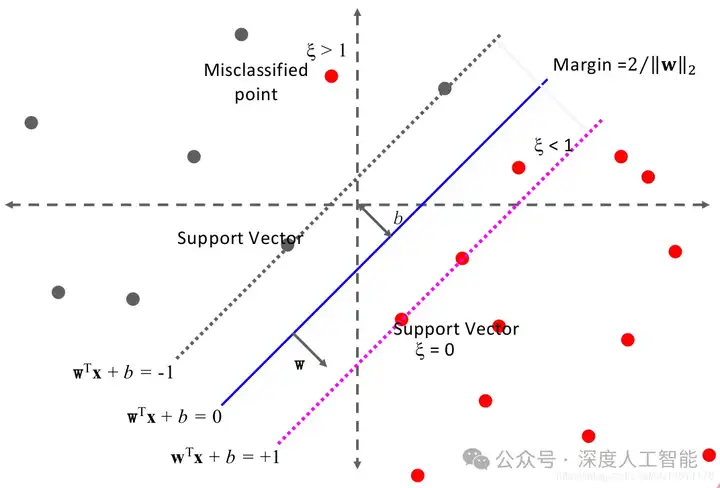
行业意义: 搜索、推荐、广告、风控、语音识别开始规模化使用机器学习。Google 的 PageRank 之后,机器学习逐渐成为搜索排序的核心;推荐系统开始用协同过滤和矩阵分解;广告点击率预测用 LR、GBDT 等模型;风控用决策树和随机森林;语音识别用 HMM + GMM。这一阶段奠定了现代 AI 的工程基础:数据、特征、模型、评估、迭代。
局限与遗产: 特征工程依赖领域知识,成本高且难以迁移。模型表达能力有限,面对图像、语音、自然语言等复杂模态时,手工特征往往不够。但这一阶段留下的方法论——训练集/验证集/测试集划分、交叉验证、正则化、偏差-方差权衡——至今仍是机器学习的基石。
05、深度学习突破阶段(2012—2017)
突破点:AlexNet 在 ImageNet 上大幅领先,GPU + 大数据 + 深度网络组合验证成功。
2012 年,Alex Krizhevsky、Ilya Sutskever 和 Geoffrey Hinton 的 AlexNet 在 ImageNet 图像分类竞赛中把 top-5 错误率从 26% 降到 15% 左右,大幅领先第二名。这不是一次小幅改进,而是一次代际跃迁。
AlexNet 的意义不只是刷新了准确率,而是验证了一个组合:GPU 提供算力,大数据提供燃料,深度网络提供表达能力。ImageNet 有超过一百万张标注图像,GPU 让卷积网络的训练变得可行,ReLU、Dropout、数据增强等技巧让深层网络能稳定训练。此后,CNN、RNN、LSTM、GAN 等架构爆发。VGG 探索了网络深度的影响,ResNet 用残差连接解决了深层网络的退化问题,Seq2Seq 让序列到序列的映射成为可能,GAN 用生成器和判别器的对抗训练来生成逼真数据,AlphaGo 则把深度学习和强化学习结合,击败了人类围棋冠军。
特征: 端到端训练、表征学习、CNN/RNN/LSTM/GAN 等架构爆发。与统计学习阶段不同,深度学习不再依赖手工特征,而是让网络自己从原始数据中学习分层表征:底层学边缘和纹理,中层学部件,高层学物体。
代表: AlexNet、VGG、ResNet、Seq2Seq、GAN、AlphaGo。
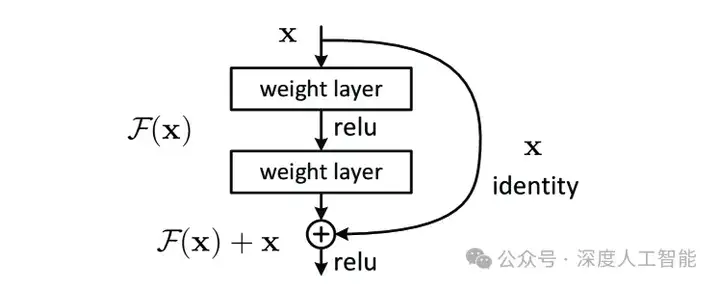
行业意义: 计算机视觉、语音识别、NLP 全面进入深度学习时代。人脸识别、自动驾驶感知、医学影像分析、智能客服、机器翻译等领域都发生了质变。AI 开始从实验室走向大规模工业应用,但每个任务仍然需要单独训练一个模型,模型之间难以复用。
局限与遗产: 深度学习依赖大量标注数据,标注成本高。模型可解释性差,调参经验性强。每个任务一个模型,开发成本高。但这一阶段证明了表征学习的威力:好的表示可以让后续任务变得简单。这为预训练范式埋下伏笔。
06、大模型与预训练突破阶段(2017—2022)
突破点:Transformer 架构 + 预训练范式,让模型可以先用海量数据学通用表示,再迁移到下游任务。
2017 年,Google 的《Attention Is All You Need》提出 Transformer 架构。它完全基于自注意力机制,解决了序列建模中的长距离依赖问题,并支持大规模并行训练。与 RNN 逐时间步计算不同,Transformer 可以同时处理整个序列,这让它在 GPU/TPU 上训练效率极高。
预训练范式则改变了 AI 的开发方式。2018 年,BERT 用掩码语言模型在海量文本上预训练,再通过微调适配下游任务,在多项 NLP 任务上刷新纪录。GPT 系列走自回归路线,GPT-2 展示了零样本能力,GPT-3 用 1750 亿参数展示了少样本学习能力。T5 把所有任务统一成文本到文本的格式,CLIP 用对比学习把图像和文本映射到同一空间。参数规模和数据规模不断攀升,模型开始展现出“通用表示”的能力。
特征: 大规模参数、海量数据、预训练 + 微调/Prompt。这一阶段的关键词是“基座模型”:先训练一个通用模型,再适配各种任务。
代表: Transformer、BERT、GPT-2、GPT-3、T5、CLIP。
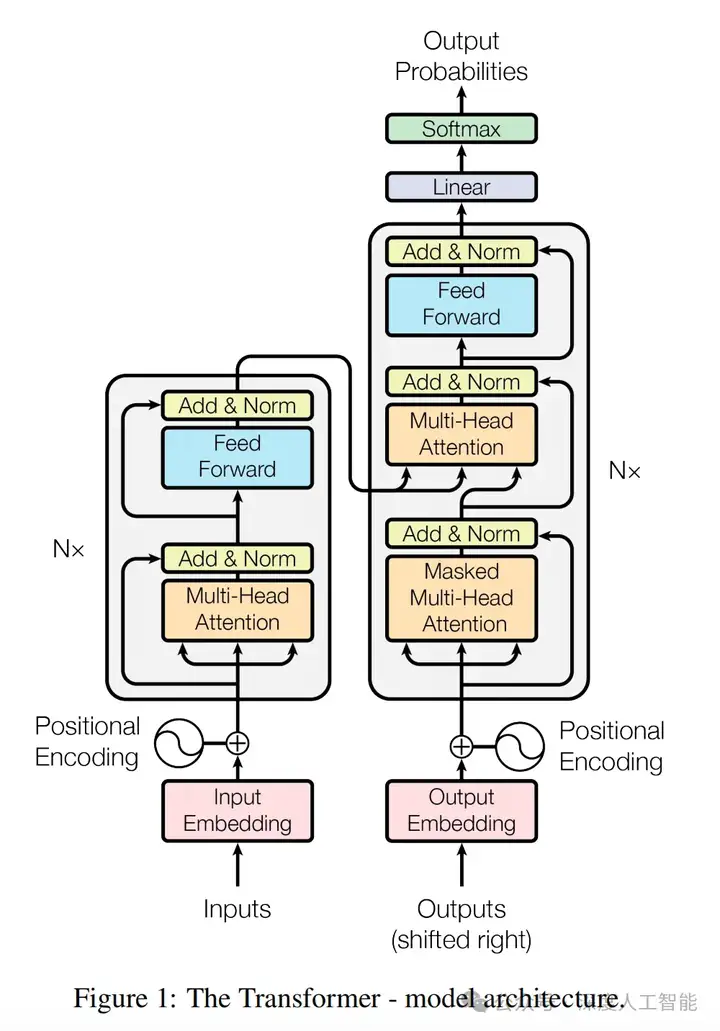
行业意义: AI 从“一任务一模型”转向“一个基座模型适配多任务”。这降低了 AI 应用的开发门槛:不需要为每个任务从头训练模型,只需要在基座模型上微调或设计 Prompt。模型即服务(MaaS)开始出现,API 调用成为主流交付方式。
局限与遗产: 大模型训练成本极高,推理成本也不低。模型可能产生幻觉,事实准确性存疑。微调仍然需要标注数据。但预训练范式证明了规模本身可以带来能力跃迁:当参数和数据达到一定规模,模型会展现出小模型不具备的涌现能力。这为下一阶段的产品化奠定了基础。
07、大模型产品化与 Agent 突破阶段(2022—至今 )
突破点:ChatGPT 让大模型进入大众产品;GPT-4、Claude、Gemini 等推动多模态和工具调用;Agent 开始能规划、调用工具、执行工作流。
2022 年 11 月,ChatGPT 发布。它在五天内获得一百万用户,两个月内月活破亿,成为历史上增长最快的消费级应用之一。ChatGPT 的意义在于,它把大模型从技术能力变成了大众产品:自然语言对话界面让普通人也能用上 AI,不需要懂编程,不需要懂模型。
随后,GPT-4、Claude、Gemini 等模型推动多模态和工具调用。GPT-4 能理解图像,Claude 强调长上下文和安全性,Gemini 原生支持多模态。工具调用让模型能调用外部 API、查询数据库、执行代码。Agent 开始能规划、调用工具、执行工作流:AutoGPT 尝试让模型自主分解任务,LangChain 提供了构建 Agent 的框架,MCP(Model Context Protocol)尝试标准化模型与工具的连接,多模态 Agent工具能看、能听、能说、能操作。
特征: API 化、插件/工具调用、RAG、多 Agent 协作、具身智能探索。这一阶段的关键词是“任务执行”:模型不再只是回答问题,而是开始真正“做事”。
代表: ChatGPT、GPT-4\5\6、Gemini、Copilot、Claude、AutoGPT、LangChain、MCP、多模态 Agent工具。
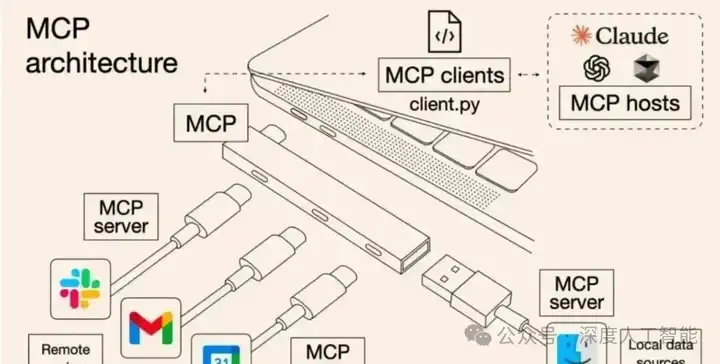
行业意义: AI 从“模型能力”走向“任务执行”,开始重塑软件形态和行业工作流。Copilot 模式嵌入编程、办公、设计工具,RAG 让企业知识库与模型结合,Agent 让自动化从“流程自动化”走向“智能自动化”。软件不再只是被动响应操作,而是能主动理解意图、规划步骤、调用工具、完成任务。
当前挑战: Agent 的可靠性仍然不足,长任务容易失败。工具调用的安全性和权限控制需要解决。多 Agent 协作的通信和协调机制尚不成熟。具身智能(机器人 + 大模型)还在早期探索。但方向已经明确:AI 正在从“生成内容”走向“执行任务”。
AI技术发展汇总表
| 阶段 | 时间 | 突破点 | 核心特征 | 代表 |
| 符号推理突破 | 1956—1960s | 达特茅斯会议;Logic Theorist、GPS | 符号、规则、逻辑;推理即智能 | 达特茅斯会议、Logic Theorist、ELIZA |
| 感知机与连接主义突破 | 1957—1969 | Rosenblatt 提出感知机 | 神经网络雏形;从数据中学习分类边界 | Perceptron、ADALINE |
| 专家系统与知识工程突破 | 1970s—1980s | 专家系统将领域知识做成规则库 | 知识工程、规则推理、行业应用 | DENDRAL、MYCIN、XCON |
| 统计学习与机器学习突破 | 1980s—2010s | 反向传播;SVM、决策树、随机森林、贝叶斯网络、HMM | 从手写规则转向从数据中学习 | BP 神经网络、SVM、Random Forest、CRF、HMM |
| 深度学习突破 | 2012—2017 | AlexNet 在 ImageNet 上大幅领先 | 端到端训练、表征学习 | AlexNet、VGG、ResNet、Seq2Seq、GAN、AlphaGo |
| 大模型与预训练突破 | 2017—2022 | Transformer + 预训练范式 | 大规模参数、预训练 + 微调/Prompt | Transformer、BERT、GPT-2、GPT-3、T5、CLIP |
| 大模型产品化与 Agent 突破 | 2022— | ChatGPT 让大模型进入大众产品;Agent 能规划、调用工具、执行工作流 | API 化、工具调用、RAG、多 Agent 协作 | ChatGPT、GPT-4\5\6、Gemini、Copilot、Claude、AutoGPT、LangChain、MCP、多模态 Agent工具 |
回看这七个阶段,主线其实很清晰:AI 的智能来源,从人工写规则,转向从数据中学习,再转向从海量数据中预训练通用表示,最后走向能规划、调用工具、执行任务的 Agent。
每一次突破,都让 AI 离“通用任务执行”更近一步。符号主义解决了“机器能否推理”,连接主义解决了“机器能否学习”,统计学习解决了“如何从数据中学习”,深度学习解决了“如何自动学习表征”,预训练解决了“如何复用通用表示”,Agent 正在解决“如何让模型真正做事”。
对于行业读者来说,理解这条主线,比记住具体年份和模型名字更重要——因为它决定了下一波技术机会会出现在哪里。如果要用一句话概括:AI 的每一次跃迁,都是“智能的来源”被重新定义。 下一个突破,很可能来自让 Agent 更可靠、更安全、更高效地执行复杂任务的方向。