一、“圣黛CP”爆火:一场算法喂养的集体狂欢
如果孙悟空和林黛玉谈起了恋爱,会是什么样子?
在网友用AI生成的视频里,当林黛玉对花垂泪时,孙悟空挥起金箍棒,让落花重返枝头;那个寄人篱下的潇湘妃子,跟着猴哥逛游乐场、吃桃子,不再流泪。网友给这对组合起了个绰号——“内耗小姐和她的万能先生”。
它之所以能刷屏,首先是一场情绪的胜利:林黛玉敏感孤傲、寄人篱下,多少人为其悲剧命运不甘,“意难平终于有了喜剧番外”;更深层的原因,在于经典的“接受前史”足够深厚,正因为86版《西游记》和87版《红楼梦》的形象深入人心,网友才能对许多不言而明的“笑点”心领神会。
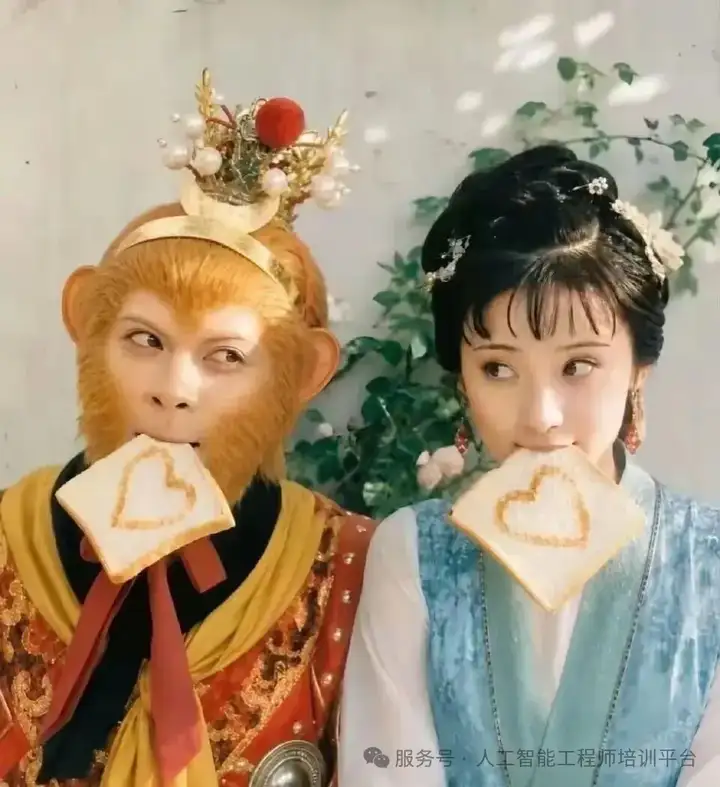
但这一轮与早年的“二创”有一个决定性差别:前几年网友把六小龄童版孙悟空与陈晓旭版林黛玉的片段剪在一起,那仍是人的剪辑,人先看懂了这两个人物,才决定把他们放在一起;而2026年这一轮,AI让“理解”变成了可选项。这才是“圣黛”真正的位置:它不是一个孤立的笑话,而是一个转折点——从“人理解了经典之后去改写它”,转向“不必理解,也能生成它”。
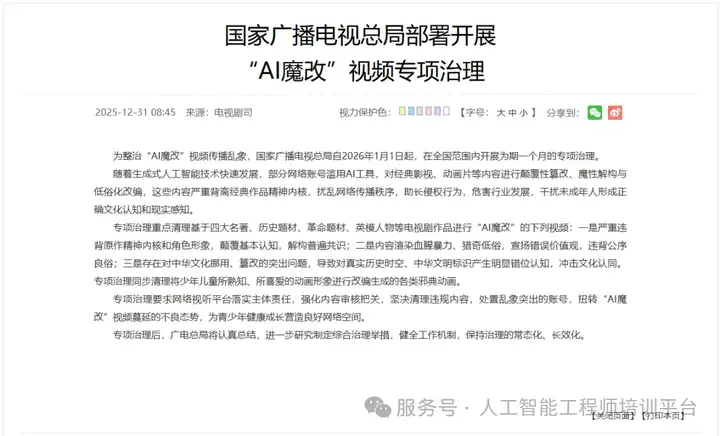
这支视频并不孤单。2026年前九个月里,类似的“震撼”接连出现,震中却不在同一个地方:年初,国家广播电视总局启动“AI魔改”视频专项治理;9月8日,OpenAI宣称其内部模型用88小时解决了纳维-斯托克斯方程;9月11日,陶哲轩、邓煜、彼得·朔尔策等25位菲尔兹奖得主联合发表声明《人工智能在数学中的严重错位》。
一边是名著人物被随意配对,一边是人类最古老的智力王国发出集体警报。它们指向同一个问题:当机器可以毫无障碍地生产结果,我们还认不认得出,什么才算真正的创造?问题已不是“AI能不能做”,而是“做到哪一步还算创新,从哪一步起就成了破坏”。这次AI带来的真正变化,是让“结果”与“过程”第一次可以彻底分家:机器可以在不了解悲欢、不理解对称的情况下,生产出看起来像那么回事的东西。
于是几乎所有领域同时被要求回答同一个问题。文化领域问:改编一部经典,到哪一步还算致敬,哪一步就成了歪曲?学术领域问:一个由机器给出、人却看不懂的证明,还算不算知识?法律领域问:用他人作品训练模型,究竟侵犯了什么?“圣黛CP”之所以值得作为案例而不是全部,恰恰因为它把这三个问题浓缩在一支三十秒的视频里。
二、AI闯进数学王国,25位菲尔兹奖得主集体发声
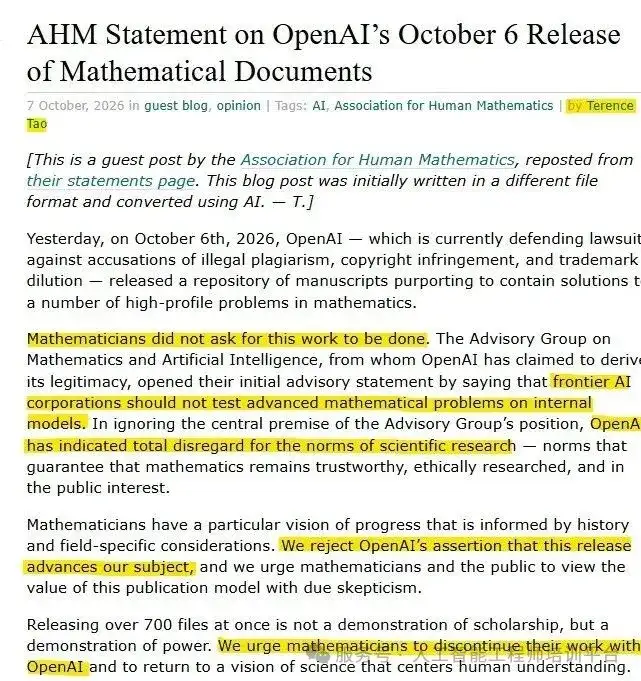
如果说“圣黛CP”触动的是文化传承,那么2026年9月的数学界风波,触动的就是人类知识生产的地基。当地时间9月11日,陶哲轩、邓煜、彼得·朔尔策(Peter Scholze)等25位菲尔兹奖得主作为最初签署人,联合发表声明《人工智能在数学中的严重错位》。声明并未否认AI的进步,反而首先承认:大语言模型的数学能力显著提升,已能解决多个数学领域的重要未决问题。真正的问题不在于“AI会不会做数学”,而在于——“AI公司的目标与数学共同体的目标存在严重错位”。导火索是9月8日OpenAI的宣布:其内部模型率领约一万个AI智能体并行工作约88小时,找到了纳维-斯托克斯方程(N-S方程)的一个反例;这是描述流体运动的核心方程,2000年被克雷数学研究所列为七大千禧年大奖难题之一。
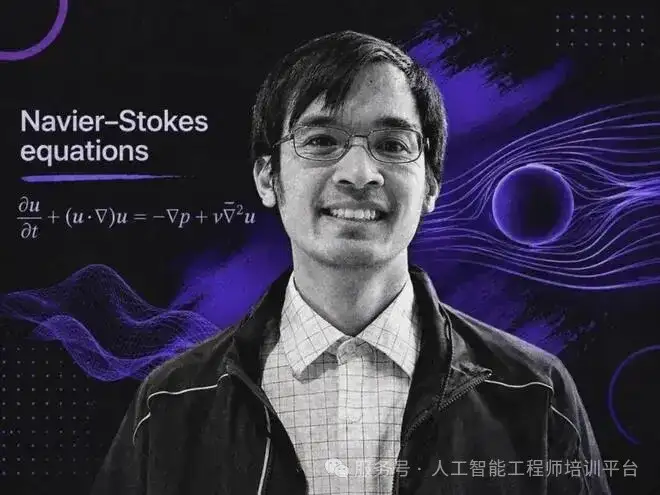
真正点燃争议的是署名与优先权。就在OpenAI官宣前一天,纽约大学柯朗数学科学研究所教授巴克马斯特与Anthropic研究员阿尔珀格已公开相关关键进展,比OpenAI早约12小时。巴克马斯特怀疑自己未发表的草稿和推导被模型“看过”,OpenAI否认指控,但承认无法排除用户数据的间接作用,也承认对方拥有优先权。1998年菲尔兹奖得主、哈佛大学讲席教授麦克马伦把这一过程比作登山:对方已在山腰建立营地,而OpenAI四处物色可以空投的位置,然后空投一队机械登山者抢先登顶——只因他们拥有一架飞得比任何人都高的直升机。更令他愤怒的是署名伦理:OpenAI曾要求把在竞争对手Anthropic任职的阿尔珀格从署名中移除,“这是纯粹金钱驱动的伦理失范,坦率地说,是一种霸凌”。
但声明并未主张拒绝AI,反而表示AI具有加强和加速真正数学研究的潜力。2018年菲尔兹奖得主菲加利则指出,“数学极其依赖非正式交流,我们会告诉同事正在做什么,在会议上讨论尚未完善的想法。这种开放只有在人们确信不会使自己处于竞争劣势时,才有正当性。”而如今只要传出有人即将解决某个问题的传闻,AI公司就会趋之若鹜。
25位数学家的担忧可以拆成四层。第一层是目标被替换。AI公司把解决数学问题当作衡量模型能力的基准,但在数学家看来,一个著名问题之所以重要,并不只是因为最后能得到“对”或“错”:重要的未解问题更像数学世界中的地标和灯塔,被解决通常意味着研究者发现了新的洞见、方法或概念,而这些成果还要经过报告、讨论和不断简化,最终才可能成为研究生甚至本科生能理解的教材内容。声明因此强调,“解决问题只是实现概念理解和洞察这一首要目标的工具和代理指标”。当“解决了多少个未解问题”成为被机器快速优化的目标,批量生产“真/假”结论,可能不是在孕育新思想,反而会摧毁孕育思想的沃土。
第二层是理解的缺席。1994年菲尔兹奖得主、南方科技大学讲席教授泽尔曼诺夫介绍,Lean是目前验证AI证明正确性的重要方式,跑通则说明严谨可接受;但问题在于人类不理解“验证成功”究竟意味着什么。麦克马伦指出,AI在神经网络里工作,同一道题的结果可能并不确定——把证明放进Lean再跑100个小时,它却可能说“我解不出来”。“这就像面对一个长达一英里的等式,你从头核对到最后,发现等式是对的,但你什么也没看懂。”
第三层是知识传承的链条被切断。即便AI能产生正确而新颖的数学思想,若没有数学家继续发展这些思想、将其整合进数学知识体系,AI产生的思想也无法真正“活起来”。泽尔曼诺夫说,数学不是国际象棋那样的纯粹智力游戏,而更像骑自行车:你无法“教会”一个人骑车,他必须自己骑上去;但AI公司正把数学变成一盘国际象棋。
第四层是人的培养被抽空。数学家给学生布置问题,不只是希望他们得到答案,更要让他们在过程中发展研究所需的能力。泽尔曼诺夫说,发展理论“这不只是为了登顶一座山,更是为了修路”;费马大定理在1994年被证明前悬置数百年,为攻克它,数论、代数几何和模形式等现代数学工具接连诞生,无数年轻人在这条路上成长为杰出数学家。但如今,康奈尔大学数学家斯特罗加茨表示,真正受影响的是数学家的自我认知,他的一位合作者坦言自己花了15年成为世界级研究者,而“我的技能已不再属于我”;有一位菲尔兹奖得主甚至开始拒绝接收研究生,理由是数学家这一职业正在死去。这就把问题推向更基础的一问:当机器越来越擅长给出答案,人类究竟希望从数学研究中得到什么?这恰恰是“边界”最准确的用法:它不是在划分谁被取代,而是在划分哪些价值可以被效率替换,哪些一旦被替换就永远消失。
三、魔改的谱系与认知的错位
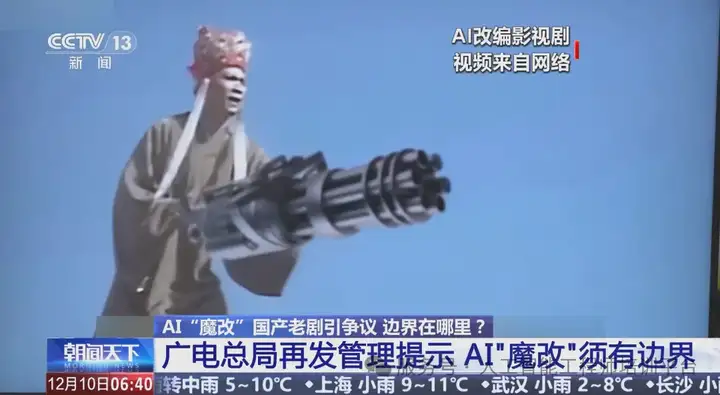
“圣黛CP”并非孤例。专项治理公告中的典型案例触目惊心:唐僧拿着机关枪扫射;华佗用电锯给关羽“刮骨疗毒”;“金陵十二钗”被变装成风尘女子;诸葛亮戴上赛文眼镜化身奥特曼。它们的共同特征,是“生成”取代了“创作”。南京师范大学文学院副院长朱怡淼辨析了二者:传统改编,无论是以《大话西游》为代表的颠覆性解构,还是以《黑神话·悟空》为代表的创新延伸,核心始终是“人的表达”,创作者对原著精神内核有深刻理解;而“AI魔改”只需人类提供指令,创作不以“理解”为前提。林黛玉原本与“悲剧美学”“诗性人格”相连,被强行赋予“暴力美学”的内涵时,其符号承载的稳定文化意涵便遭到侵蚀。
比侵权更隐蔽的风险是认知错位。心理学研究指出,人对某一对象的首次认知会形成持久的心理图式,后续信息往往被用于强化这一初始印象,而非修正它:对数字原生代而言,他们与经典的“首次相遇”很可能已不是原著,而是被魔改的AI视频。朱怡淼分析了这种风险的形成机制:如果受众在不了解经典的情况下消费魔改内容并获得娱乐满足,这种满足反过来会消解深入理解原典的动力,形成“浅层魔改—快速消费—降低期待—更浅魔改”的恶性循环——一旦魔改成为一代人对经典的首次认知和主导印象,经典的价值内核、审美理想、精神气质就会被架空。
更令人担忧的是,魔改已经形成产业链:社交平台公然出现教程,只需输入“黑化”“腹黑”“猎奇”等指令,颠覆经典的视频便可源源不断生成。治理数据也勾勒出这场持久战的规模:9月单月,抖音、快手、微信、小红书、哔哩哔哩、百度合计处置近13000条,微信今年以来累计下架AI篡改短视频2.6万余条。快手还特别点明两类重点对象:对《西游记》《红楼梦》人物进行“不当婚恋关联”,以及对《喜羊羊与灰太狼》进行低俗改编。这意味着“圣黛CP”所代表的情感二创,恰恰处于治理的靶心。
四、版权的地图正在被
一旦追问“凭什么可以用别人的形象、别人的片段、别人的智力成果”,问题就落到了版权法上,而这恰是AI冲击下最像“无人区”的地方。
第一场争端围绕训练数据:用他人作品训练模型究竟属于合理使用还是构成侵权,各国答案截然不同——英国有盖蒂图片社(Getty Images)诉Stability AI案,欧盟有GEMA对OpenAI与Suno AI的诉讼,美国大量作家、艺术家和新闻机构的诉讼长期在“转换性使用”与“市场替代”之间拉锯,中国则把焦点落在服务提供者是否尽到注意与审查义务上。
第二场争端围绕“AI生成的内容算不算作品、归谁所有”。我国司法实践已给出较为明确的取向:2026年,广州一起盗录AI短剧案中,覃某某、沙某某未经著作权人许可,翻录复制至少1716部作品后生成分享链接贩卖传播,法院认定其侵犯了AI提供方与用户共同享有的AI短剧著作权,并依法追究刑事责任。办案检察官张秋杰解释,AI生成物如果主要凝聚了人的创作意志,则可受著作权法保护;如果只是对已有素材的简单安排组合,就不属于人的独创性表达。关键在于人是否具有“强引导、强限定”。
第三场争端围绕授权与改编的界限。北京互联网法院法官朱阁提供了一个法律视角:“影视作品有权利人,而‘二创’发布后可以获得流量收益。根据《著作权法》,未经许可用到作品中具有独创性表达的画面,无论片段长短,都涉及侵权。”但即便获得改编授权,也并非“为所欲为”:“严重违背原作精神内核和角色形象”,可能侵犯原著作者的“保护作品完整权”。这种人身权的保护没有期限。
三场争端的难度并不相同。权属问题其实已在收敛:我国的路径是回到老问题——有没有人的独创性表达、有没有强引导强限定,而不是新造一个“AI作品”的法律类别。真正难以弥合的是训练数据:AI的价值恰恰来自规模化的“学习”,而著作权法的核心承诺恰恰是“未经许可不得使用”,两个逻辑几乎天然对立。于是立法只能以另一种节奏推进,先解决“看得见”的问题:我国《人工智能生成合成内容标识办法》自2025年9月1日起施行,要求在权属与训练数据尚无定论之前,先把“知情”这一前置条件还给公众。
五、四个维度与一条底线边
第一个维度是法律边界:是否存在未经许可的独创性表达使用,是否侵犯改编权、保护作品完整权,是否履行了生成内容标识义务。第二个维度是伦理边界:是否以欺骗为目的,是否贬损真实人物或群体,是否有系统性误导特定人群(尤其是未成年人)的效果。有专家以三个维度构建评判标准——是否违背公序良俗、是否歪曲史实、是否侵害原作权利;也有观点认为,若改编导致原作社会评价降低、误导认知,即可倾向认定为恶意“魔改”,若在合理范围内且具有创新价值,则属于二次创作。
第三个维度是认知边界:是否阻断了理解的发生。这是最不显眼、也最容易被忽略的一条,但数学界的教训表明,它可能是代价最高的一条。如果一代人对经典的首次认知来自魔改视频,下一代数学家的训练过程被“直接给答案”替代,那么被丢掉的不只是某部作品或某个学科,而是让人能提出问题、产生品味、分辨好坏的那套机制。第四个维度是生态边界:收益归谁,成本由谁承担。魔改视频的收益归上传者与平台,认知代价却由整个社会的文化传承承担;AI公司解决了千禧年难题,声誉与融资归自己,而维护学术优先权、成果引用与人才培养的那套非正式制度被损耗。任何一方只要长期“取用而不回填”,这个生态迟早会枯竭。
这里还有一个更隐蔽也更难解的悖论。AI的输出在“结果层”上往往与人类创作难以区分——那支AI视频确实让人笑了,那份AI证明确实通过了形式化验证;但在“过程层”上,它可能是空的。而我们的法律、评价体系和注意力机制都偏向结果,我们的教育、学术传统却依赖过程。这种不对称,正是所有断裂的真正来源:不是AI做出了坏东西,而是AI做出了看起来很好的东西,于是我们不再需要走那条通往理解的路。
六、该把闸门交给谁
治理从来不是“一刀切”。AI工具也让不少令人欣喜的创意视频涌现:有作品让演员与数十年前饰演过的角色同框握手,有汉服爱好者用AI让央视版《三国演义》中的人物换上更符合历史的甲胄衣冠。人民日报的评论给出了更具弹性的表述:在依法保护相关权益、守住公序良俗底线的前提下,给充满意趣的“我注经典”留下空间;而对于调侃英雄、解构崇高、颠覆基本认知的恶意篡改,对于渲染血腥暴力、追逐猎奇低俗的魔性改编,必须划出红线。同样是借《西游记》二创,《大话西游》与《黑神话·悟空》成为经典,而“赛文版诸葛亮”“加特林版曹操”除了玩噱头、博眼球之外,到底提供了什么价值?
数学界给出的答案同样不是停下:麦克马伦提出三个关键词——研究范式、规则,以及AI公司自身信奉的价值观。他认为真正的转型必须发生在AI公司以及数学家群体内部,前者应重新审视模型“军备竞赛”给社会带来的负面影响,后者应积极探索AI辅助下的成果评估体系。把两边的话放在一起,路径其实是同一条:让过程重新进入评价。平台不能唯流量是从,而应更加重视内容品质与综合评价;学术评价不能把“解决了多少问题”当作唯一标尺,而要建立能衡量理解、引用与传承的新规则。
人民日报的评论说得好:层出不穷的二创视频并不解渴,热闹30秒,走红两三天,之后就随风而逝,那不是我们为经典所做的全部。真正值得追求的,不是更快地得到结果,而是让结果能被理解、被引用、被传递、被继续。“圣黛CP”证明了经典足够厚重,足以被反复改写而不倒,但它同时也证明了,一代人可以在完全不了解经典的情况下,先爱上经典的影子。名著不会因为二创而消亡,数学也不会因为AI而停止,但只有当人类仍然愿意亲自走完那段通往理解的路,边界才不会在效率的欢呼声中被悄悄抹去。